
昨天我們的 naive_chunk 有個很大的問題它每 100 個字就切一刀,完全不管句子講完了沒。不過當時的知識庫只有 5 句話,每句都不到 100 個字,它連犯錯的機會都沒有,檢索結果自然看起來還不錯。但真實世界的文件可沒這麼好處理,文件一變長,這把刀馬上就會切到不該切的地方,更可怕的是模型不會報錯,只會用非常篤定的語氣回答一個錯的答案,你甚至不知道它已經壞了。
所以今天我們就來好好處理 Chunking,實作五種常見的切塊策略,並且用同一份文件、同一組問題,看看哪一種最不容易把答案切碎。
這篇的完整程式碼一樣會放在 GitHub repo:https://github.com/AUSTIN2526/30-days-ironman-agent,可以直接下載下來執行。
Token 是 LLM 處理文字的最小單位,而 Chunk 則是 RAG 系統裡最小的檢索單位。也就是說,不管後面的 Embedding 模型多強、向量資料庫多快,模型最後能看到的永遠只有被檢索出來的那幾塊,其他內容對它來說就跟不存在一樣。
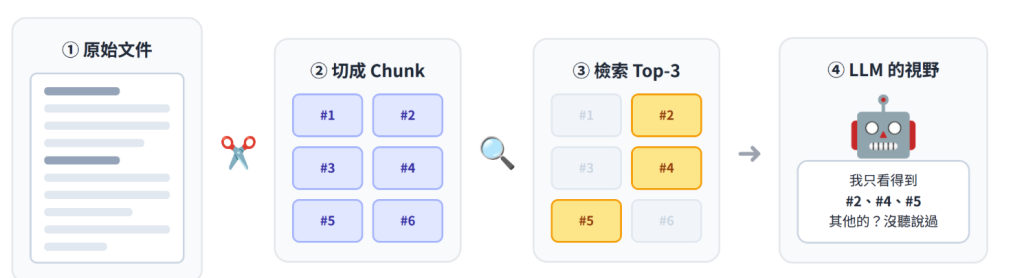
所以只要答案在切塊時就被切壞了,後面的 Retrieval 和 Generation 再怎麼努力都救不回來,切塊的品質直接決定了整條流程的天花板。而 Chunk 切得不好,大致上會有兩種下場:
| 狀況 | 會發生什麼事 |
|---|---|
| 切太大 | 一塊裡同時講了特休、病假、報帳好幾件事,轉成向量後語意被平均掉,跟哪個問題都有點像,又都不夠像。塞進 Prompt 時還會狂吃 Context Window。 |
| 切太小/切錯位置 | 一句話被切成兩半,答案的前半段在 A 塊、後半段在 B 塊,不管檢索到哪一塊資訊都不完整,模型只好自己腦補。 |
前者就是 Day 3 提過的 Context Window 問題,後者則會直接把我們送回 Day 6 的幻覺現場。如果還是覺得有點抽象,可以想像你要把一本員工手冊剪成一張張便利貼,貼在白板上給同事查:
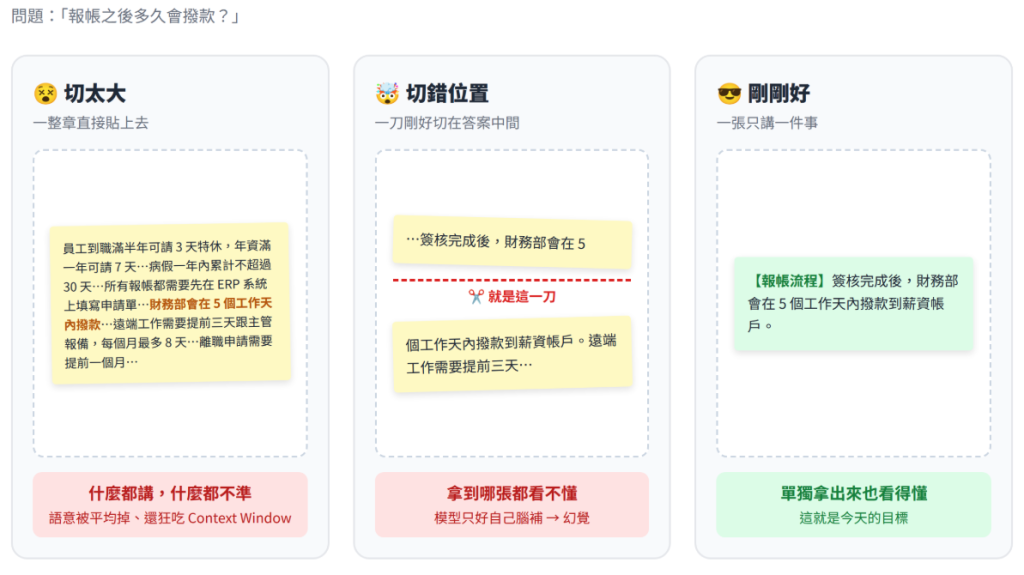
所以好的 Chunking 方式,就是讓每一塊剛好講完一件事,而且單獨拿出來也讀得懂。
今天我們把知識庫升級成一份用 Markdown 寫的員工手冊,裡面有章節、有小節,也有比較長的段落,比較接近實際會遇到的文件,可以從這裡下載。
且的專案結構如下,所有切塊策略都集中在 chunkers.py,方便之後直接 import 到 Indexing 裡使用:
day08-chunking/
├── handbook.md          # 知識庫(員工手冊)
├── chunkers.py          # 五種切塊策略
├── compare_chunks.py    # 把每種策略切出來的結果印出來看
└── evaluate.py          # 用同一組問題比較檢索效果
接下來就讓我們一個一個看,常見的切塊策略有哪些,又各自會踩到什麼坑。
第一個就是我們昨天的老朋友,這次改名叫 fixed_chunk:
# chunkers.py
import re

import numpy as np


def fixed_chunk(text: str, chunk_size: int = 100) -> list[str]:
    return [text[i:i + chunk_size] for i in range(0, len(text), chunk_size)]
單看程式碼可能不太容易想像它是怎麼切的,所以我們直接執行 compare_chunks.py,把它切出來的結果印出來:
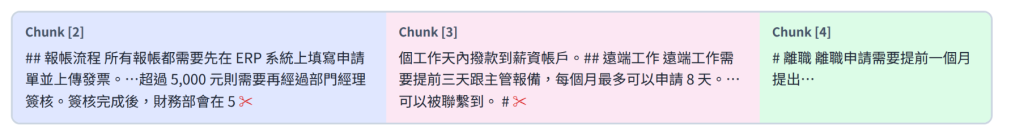
可以看到問題一次出現了三個。第一個是答案被切成兩半,如果使用者問報帳之後多久會撥款,[2] 的結尾是「財務部會在 5」,[3] 的開頭卻是「個工作天內撥款」,不管檢索到哪一塊都拿不到完整的答案。第二個是一塊裡混了兩個主題,[3] 前半段在講報帳、後半段在講遠端工作,這種塊的向量會落在兩個主題中間,兩邊都不太像。第三個是連 Markdown 標題都被切爛了,## 離職 被拆成 [3] 結尾的 # 和 [4] 開頭的 # 離職,後者甚至從二級標題變成了一級標題。
從這裡就能看出來,固定長度切割完全不在乎文字的內容,拿來當 baseline 還可以,但真正的系統不可能這樣做。
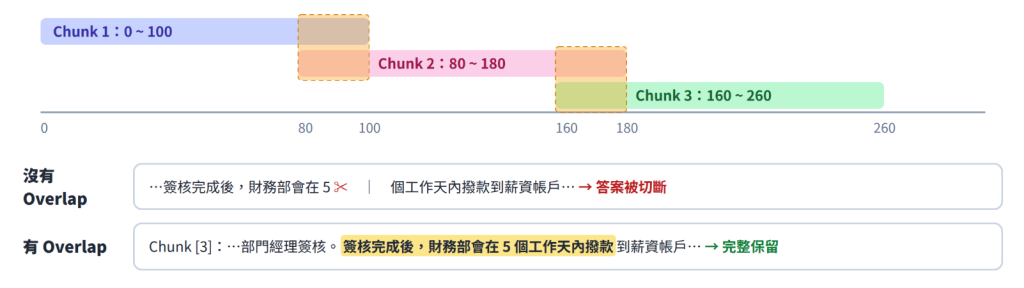
既然問題出在切斷的地方剛好在答案中間,最直覺的補救方式就是讓相鄰的兩塊有一段重疊,也就是 Overlap。這樣就算某一刀切在句子中間,那句話也會完整地出現在下一塊的開頭。
def overlap_chunk(text: str, chunk_size: int = 100, overlap: int = 20) -> list[str]:
    assert 0 <= overlap < chunk_size, "overlap 必須小於 chunk_size"
    step = chunk_size - overlap
    chunks = []
    for i in range(0, len(text), step):
        chunks.append(text[i:i + chunk_size])
        if i + chunk_size >= len(text):  # 已經切到結尾就停,避免最後多一塊純重疊的碎片
            break
    return chunks
程式碼跟 fixed_chunk 比起來只改了一個地方,就是每次往前走的步長從 chunk_size 變成 chunk_size - overlap。以 chunk_size=100、overlap=20 來說,第一塊是 0~100,第二塊是 80~180,中間這 20 個字會同時出現在兩塊裡。
===== overlap:共 6 塊,平均 94 字 =====
[3] '金額在 5,000 元以下由直屬主管簽核即可;超過 5,000 元則需要再經過部門經理簽核。簽核完成後,財務部會在 5 個工作天內撥款到薪資帳戶。\n\n## 遠端工作\n\n遠端工作需要提前三天跟主管報備,'
這時可以看到撥款的答案終於完整出現在同一塊裡了。不過重疊的部分會被 Embedding 兩次、存兩份,Retrieval 時也可能把兩塊高度重複的內容一起塞進 Prompt,白白浪費 Token。而且它沒有解決一塊混了兩個主題和標題被切爛的問題,只是讓切錯的機率變小一點。
所以我們需要更好的切法,也就是一開始就不要切錯,盡量沿著文章本來的邊界下刀,這就是遞迴切割。
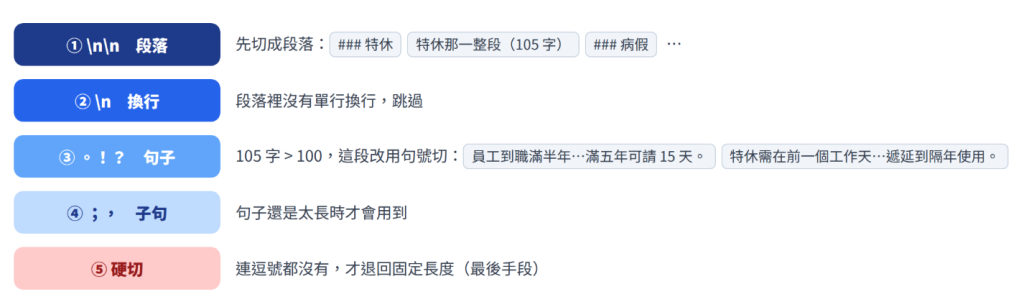
這種做法需要準備一份由大到小的分隔符號清單,先用最大的邊界切,切出來還是太大的片段,再換下一個比較小的邊界繼續切,通常會長得像這樣:
| 優先順序 | 分隔符號 | 代表的邊界 |
|---|---|---|
| 1 | \n\n |
段落 |
| 2 | \n |
換行 |
| 3 | 。 ! ? |
句子 |
| 4 | ; , |
子句 |
| 5 | (都沒有) | 最後才退回固定長度硬切 |
這其實就是
LangChain裡RecursiveCharacterTextSplitter的核心概念
一開始要先把文字依照分隔符號拆開,但要注意 Python 的 str.split() 會把分隔符號吃掉,直接用的話切完的句子全都會少一個句號,所以我們要手動把它接回每一段的結尾。
SEPARATORS = ["\n\n", "\n", "。", "!", "?", ";", ","]


def _split_keep_sep(text: str, sep: str) -> list[str]:
    """用 sep 切開,但把 sep 留在前一段的尾巴,句號才不會不見。"""
    parts = text.split(sep)
    pieces = [p + sep for p in parts[:-1]] + [parts[-1]]
    return [p for p in pieces if p.strip()]
接下來會稍微複雜一點。我們先判斷文字長度是否已經夠小,夠小就直接回傳,不夠小就找出文字裡第一個出現的分隔符號,把它切成更小的片段,最後再把相鄰的片段合併起來,直到接近長度上限為止。
def recursive_chunk(text: str, chunk_size: int = 100, separators: list[str] = SEPARATORS) -> list[str]:
    # 1. 本身就夠小,直接回傳
    if len(text) <= chunk_size:
        return [text.strip()] if text.strip() else []

    # 2. 找出第一個出現在文字裡的分隔符號;都沒有就只能硬切
    sep = next((s for s in separators if s in text), None)
    if sep is None:
        return fixed_chunk(text, chunk_size)
    next_seps = separators[separators.index(sep) + 1:]

    # 3. 切成小片段後,由左到右「貪婪合併」,塞得下就繼續塞
    chunks, buffer = [], ""
    for piece in _split_keep_sep(text, sep):
        if len(piece) > chunk_size:
            # 這一片自己就太大,先把 buffer 收掉,再用更細的分隔符號往下切
            if buffer.strip():
                chunks.append(buffer.strip())
            buffer = ""
            chunks.extend(recursive_chunk(piece, chunk_size, next_seps))
        elif len(buffer) + len(piece) <= chunk_size:
            buffer += piece
        else:
            chunks.append(buffer.strip())
            buffer = piece
    if buffer.strip():
        chunks.append(buffer.strip())
    return chunks
遞迴的終止條件,我們要設定成當文字長度已經小於 chunk_size,就代表它符合大小限制,不需要再切。並且,如果單純用 \n\n 切,會產生很多像 ### 特休 這種只有幾個字的碎片,所以程式會在不超過 chunk_size 的前提下我們還要把相鄰的小片段盡量併在一起,讓每一塊的長度接近上限。
不過要注意有些片段就算用目前的分隔符號切開,單獨一段還是超過 chunk_size,例如特休那一整段有 105 個字,所以我們要使用遞迴的作法,把它丟回 recursive_chunk,但改用比較細的 next_seps,像是句號,從粗的結構一路往細的結構切,直到每一塊都符合大小限制為止。
===== recursive:共 8 塊,平均 56 字 =====
[0] '# 員工手冊\n\n## 請假制度\n\n### 特休'
[1] '員工到職滿半年可請 3 天特休。年資滿一年可請 7 天特休,滿兩年可請 10 天,滿三年可請 14 天,滿五年可請 15 天。'
[2] '特休需在前一個工作天透過 HR 系統提出申請,當年度未休完的特休可以遞延到隔年使用。'
[3] '### 病假\n\n員工因病需要請假時,一年內累計不超過 30 天的部分薪資折半發放。連續請病假超過 3 天,需要附上醫院開立的診斷證明。\n\n## 報帳流程'
[4] '所有報帳都需要先在 ERP 系統上填寫申請單並上傳發票。單筆金額在 5,000 元以下由直屬主管簽核即可;超過 5,000 元則需要再經過部門經理簽核。'
[5] '簽核完成後,財務部會在 5 個工作天內撥款到薪資帳戶。'
[6] '## 遠端工作\n\n遠端工作需要提前三天跟主管報備,每個月最多可以申請 8 天。遠端工作期間必須保持通訊軟體上線,並且在上午 10 點到下午 4 點之間可以被聯繫到。\n\n## 離職'
[7] '離職申請需要提前一個月提出,並完成工作交接清單。最後一個工作日需要歸還筆電與門禁卡,薪資會在次月的發薪日結清。'
可以發現這個結果已經比前兩種好很多,大部分的塊都在句號或段落結束的地方收尾,不會再有句子被硬生生切成兩半,不過仔細看還是有問題像 [0] 整塊只有標題,沒有任何內容,就算被檢索出來也沒辦法回答問題。
更麻煩的是 [5],它只有簽核完成後撥款這句話,單獨拿出來根本不知道是在簽核什麼,因為真正關鍵的報帳兩個字被留在上一塊了。這時檢索能不能成功,就只能看 Embedding 模型能不能從簽核和撥款這些字眼推測出它在講報帳,結果會變得很不穩定。
遞迴切割最大的問題,是它把 Markdown 標題當成一般文字處理,不知道標題其實有特殊的結構意義。對人來說,標題往往是理解一段內容最重要的上下文,我們之所以知道簽核完成後撥款是在講報帳,就是因為這段內容位在報帳流程這個章節底下。
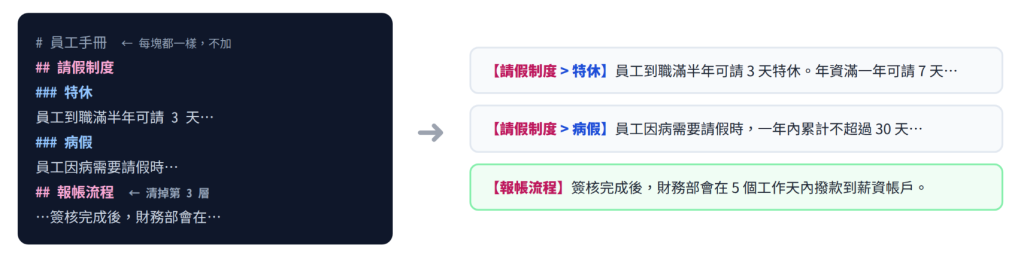
所以第四種策略會先依照 Markdown 標題把文件拆成一個個章節,再把每一塊所屬的標題路徑直接加進內容裡。這樣一來,就算撥款那句話被單獨拿出來,前面也會帶著報帳流程的上下文,當使用者問報帳之後多久會撥款時,這一塊本身就同時包含報帳、撥款和 5 個工作天這些關鍵資訊,不用完全依賴 Embedding 模型去猜。
def markdown_chunk(markdown: str, chunk_size: int = 100) -> list[str]:
    chunks = []
    headers = {}          # 例如 {1: "員工手冊", 2: "請假制度", 3: "特休"}
    body_lines = []

    def flush():
        body = "\n".join(body_lines).strip()
        if not body:
            return
        # 標題路徑只留第 2 層以下,第 1 層是整份文件的名稱,每塊都一樣就沒有鑑別度
        path = " > ".join(headers[k] for k in sorted(headers) if k >= 2)
        prefix = f"【{path}】" if path else ""
        for piece in recursive_chunk(body, chunk_size - len(prefix)):
            chunks.append(prefix + piece)

    for line in markdown.splitlines():
        match = re.match(r"^(#{1,6})\s+(.*)", line)
        if match:
            flush()
            body_lines = []
            level = len(match.group(1))
            headers = {k: v for k, v in headers.items() if k < level}  # 換章節時,把更深層的標題清掉
            headers[level] = match.group(2).strip()
        else:
            body_lines.append(line)
    flush()
    return chunks
在這個程式中主要注意兩個地方,第一個是傳給 recursive_chunk 的長度是 chunk_size - len(prefix),而不是 chunk_size,因為最後還要把標題路徑加在前面,必須先預留前綴的空間,整塊才不會超過上限。
第二個是我們刻意不把第 1 層標題放進去,因為員工手冊這四個字每一塊都會有,對區分內容完全沒有幫助,反而會佔用空間、稀釋真正有鑑別度的關鍵詞。
而這次文件就被切得很漂亮,不過它只適用於本身就有結構的文件,HTML 和有目錄的 PDF 都沒問題,但如果是一整篇沒有任何標題的逐字稿或聊天紀錄,它就無用武之地了。
===== markdown:共 7 塊,平均 64 字 =====
[0] '【請假制度 > 特休】員工到職滿半年可請 3 天特休。年資滿一年可請 7 天特休,滿兩年可請 10 天,滿三年可請 14 天,滿五年可請 15 天。'
[1] '【請假制度 > 特休】特休需在前一個工作天透過 HR 系統提出申請,當年度未休完的特休可以遞延到隔年使用。'
[2] '【請假制度 > 病假】員工因病需要請假時,一年內累計不超過 30 天的部分薪資折半發放。連續請病假超過 3 天,需要附上醫院開立的診斷證明。'
[3] '【報帳流程】所有報帳都需要先在 ERP 系統上填寫申請單並上傳發票。單筆金額在 5,000 元以下由直屬主管簽核即可;超過 5,000 元則需要再經過部門經理簽核。'
[4] '【報帳流程】簽核完成後,財務部會在 5 個工作天內撥款到薪資帳戶。'
[5] '【遠端工作】遠端工作需要提前三天跟主管報備,每個月最多可以申請 8 天。遠端工作期間必須保持通訊軟體上線,並且在上午 10 點到下午 4 點之間可以被聯繫到。'
[6] '【離職】離職申請需要提前一個月提出,並完成工作交接清單。最後一個工作日需要歸還筆電與門禁卡,薪資會在次月的發薪日結清。'
這裡要強調一點,結構切割並不是要取代遞迴切割,兩者其實是搭配使用的。程式會先用 Markdown 標題把文件切成章節,如果某個章節還是太長,再交給 recursive_chunk 用句號、段落等更細的分隔符號繼續切,這樣既能保留文件原本的結構,又能控制每一塊的大小。
那如果文件本身沒有標題、段落也不明顯,前面的結構切割就派不上用場,這時最後一種策略就是讓 Embedding 模型自己判斷話題在哪裡轉換。它的做法是把整份文件拆成一句一句,用 Embedding 模型把每一句轉成向量,因為語意相近的句子向量也會比較接近,所以我們可以計算相鄰兩句之間的相似度。
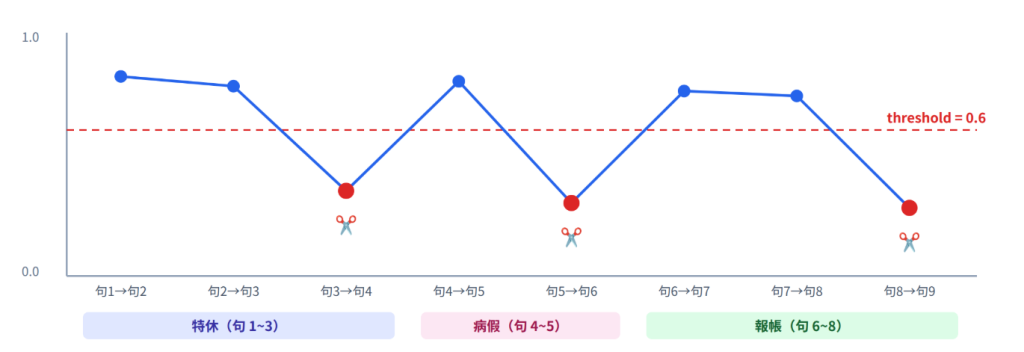
如果連續幾句的相似度都很高,代表它們大概還在討論同一個主題,就繼續放在同一塊裡;反過來,如果某個位置的相似度突然大幅下降,就代表前後兩句已經換了話題,這裡就是切割點。
def split_sentences(text: str) -> list[str]:
    sentences = re.split(r"(?<=[。!?\n])", text)
    return [s.strip() for s in sentences if s.strip()]


def semantic_chunk(text: str, model, threshold: float = 0.6, chunk_size: int = 200) -> list[str]:
    sentences = split_sentences(text)
    if not sentences:
        return []

    vecs = model.encode(sentences, normalize_embeddings=True)
    vecs = np.asarray(vecs, dtype="float32")

    chunks, current = [], sentences[0]
    for i in range(1, len(sentences)):
        similarity = float(vecs[i - 1] @ vecs[i])   # 相鄰兩句的 cosine similarity
        too_long = len(current) + len(sentences[i]) > chunk_size
        if similarity < threshold or too_long:     # 話題轉了、或塞不下了,就切一刀
            chunks.append(current)
            current = sentences[i]
        else:
            current += sentences[i]
    chunks.append(current)
    return chunks
實作上有兩個細節要注意。第一個是相似度的計算,因為我們在 Day 7 已經用 normalize_embeddings=True 把每個向量正規化成長度 1,所以這裡直接用 @ 算內積,得到的結果就是 cosine similarity。第二個是 too_long 這個判斷,就算前後句子的語意一直很接近,也不能讓同一塊無限制地長下去,所以當目前這塊已經夠長時,即使話題還沒變也要強制切開。
語意切割雖然能依照話題找到自然的切割點,但代價也比較高。首先,Indexing 時必須先幫每一句產生 Embedding,切完後每一塊還要再算一次,成本比前面幾種規則式切割高。其次,threshold 不容易設定,因為不同 Embedding 模型的相似度分布都不一樣,換模型後通常得重新調整。最後,它對本身就有清楚結構的文件反而可能出問題,像 ## 報帳流程 這種標題行會被當成一句話,因為跟前後內容相似度都不高而被單獨切出來。所以語意切割比較適合沒有明確結構、但話題會自然轉換的文件,例如會議逐字稿或客服對話,而不是用來取代結構切割。
我自己在測試時不會直接說哪一種比較好,而且光用眼睛看也不夠,所以通常會準備一些資料集裡的問題來測試,每一題都附上答案裡一定要出現的關鍵片段,再看每一種策略檢索出來的結果裡有沒有包含它:
# evaluate.py
import faiss
import numpy as np
from sentence_transformers import SentenceTransformer

from chunkers import semantic_chunk
from compare_chunks import handbook, strategies

model = SentenceTransformer("BAAI/bge-small-zh-v1.5")

# 語意切割需要 Embedding 模型,所以另外加進來
strategies["semantic"] = lambda t: semantic_chunk(t, model, threshold=0.6)

# 測試題:問題 + 答案裡「一定要出現」的關鍵片段
test_cases = [
    ("我年資三年可以請幾天特休?", "滿三年可請 14 天"),
    ("特休沒休完會怎樣?", "遞延到隔年"),
    ("請病假超過幾天要附證明?", "超過 3 天,需要附上醫院開立的診斷證明"),
    ("報帳金額超過多少要給經理簽?", "超過 5,000 元則需要再經過部門經理簽核"),
    ("報帳之後多久會撥款?", "5 個工作天內撥款"),
    ("遠端工作的時候幾點要能被聯繫到?", "上午 10 點到下午 4 點"),
    ("離職最後一天要還什麼東西?", "歸還筆電與門禁卡"),
]
接著用 build_index 把昨天 indexing.py 的流程整理成一個函式,針對每一種策略分別建立自己的索引,方便用相同的問題比較檢索效果。
def build_index(chunks: list[str]) -> faiss.Index:
    vecs = model.encode(chunks, normalize_embeddings=True).astype("float32")
    index = faiss.IndexFlatIP(vecs.shape[1])
    index.add(vecs)
    return index


def evaluate(chunks: list[str], top_k: int = 3) -> tuple[float, float]:
    index = build_index(chunks)
    queries = [q for q, _ in test_cases]
    q_vecs = model.encode(queries, normalize_embeddings=True).astype("float32")
    _, indices = index.search(q_vecs, top_k)   # 一次查全部問題,形狀是 (題數, top_k)

    hit1 = hitk = 0
    for (_, answer), idxs in zip(test_cases, indices):
        retrieved = [chunks[i] for i in idxs if i != -1]
        hit1 += answer in retrieved[0]
        hitk += any(answer in c for c in retrieved)
    n = len(test_cases)
    return hit1 / n, hitk / n
還記得昨天說過 index.search() 可以一次處理多個問題嗎?這裡直接把 7 個問題一起送進去,得到形狀為 (7, 3) 的 indices,每一列就是一個問題的前三名。
評估時主要看兩個指標,Hit@1 是看第一名有沒有包含答案,也就是最相關的結果是不是對的;Hit@3 則是看前三名裡有沒有任何一塊包含答案,也就是正確資訊有沒有機會被送進 Prompt 讓 LLM 回答。
if __name__ == "__main__":
    print(f"{'策略':<10}{'塊數':>6}{'平均長度':>8}{'Hit@1':>8}{'Hit@3':>8}")
    for name, chunker in strategies.items():
        chunks = chunker(handbook)
        avg_len = np.mean([len(c) for c in chunks])
        hit1, hit3 = evaluate(chunks)
        print(f"{name:<10}{len(chunks):>6}{avg_len:>8.0f}{hit1:>8.0%}{hit3:>8.0%}")
python evaluate.py
| 策略 | 塊數 | 平均長度 | Hit@1 | Hit@3 |
|---|---|---|---|---|
| fixed | 5 | 92 | 71% | 86% |
| overlap | 6 | 94 | 86% | 100% |
| recursive | 8 | 56 | 100% | 100% |
| markdown | 7 | 64 | 100% | 100% |
| semantic | 7 | 63 | 100% | 100% |
可以看到 fixed 的 Hit@3 剛好停在 86%,7 題只答對 6 題,唯一答錯的就是報帳撥款那題,那題的答案一開始就被切成兩塊,不管之後換成多強的 Embedding 模型,都不可能把完整答案檢索回來。
overlap 雖然把答案救了回來,讓 Hit@3 拉到 100%,但 Hit@1 只有 86%。重疊讓好幾塊的內容長得很像,一塊裡又混了兩個主題,正確答案不一定能排到第一名。這也是今天最重要的觀念,Chunking 決定了檢索的上限,Embedding 和 Reranking 只能在這個上限之內優化。
至於 recursive、markdown 和 semantic 三種策略都拿到滿分,只要沿著句子和段落的邊界下刀就已經足夠,前面提到 recursive 有一塊少了報帳兩個字,這次卻沒有失分,是因為整份手冊只有報帳流程提到撥款,Embedding 模型不太會認錯。但如果知識庫裡同時有報帳、採購、請款好幾種需要簽核和撥款的流程,少了標題上下文的塊就很容易被排錯,那時 markdown 的優勢才會真正顯現。
不過目前的測試只有 7 個問題、一份文件,三種策略同分也說明這組題目已經分不出它們的差距,所以實際應用時,應該用自己的文件和使用者真正會問的問題來測,才能準確評估 Chunking 策略的效果。
今天我們實作了五種切塊策略,再最後我們整理一下它們各自的定位:
| 策略 | 優點 | 缺點 | 適合的文件 |
|---|---|---|---|
| 固定長度 | 最簡單、可預測 | 會切斷句子、混雜主題 | 只適合當 baseline |
| 固定長度 + Overlap | 降低切斷答案的機率 | 內容重複、治標不治本 | 沒有明顯標點的文字 |
| 遞迴切割 | 沿著段落與句子邊界切 | 不懂標題,會失去上下文 | 一般文章、通用的預設選擇 |
| 結構切割 | 每塊都帶有章節上下文 | 文件必須本身有結構 | Markdown、HTML、有目錄的文件 |
| 語意切割 | 不需要結構也能依話題切 | Indexing 成本高、門檻難調 | 逐字稿、對話紀錄 |
如果你不知道該選哪一個我建議先用遞迴切割當預設,文件有結構就疊上結構切割,最後再用自己的問題去測,不要憑感覺選。
不過今天在寫語意切割和評估腳本時,我們一直都用同一個 bge-small-zh-v1.5,但語意切割的門檻換了模型就要重調,Hit@1 的結果也會跟著模型改變,那 Embedding 模型到底該怎麼選?明天我們就來把昨天說好的 Embedding 模型選型補上,實際比較幾個常見的中文與多語言 Embedding 模型,看看模型大小、向量維度跟檢索效果之間的取捨,那我們明天見!


 iThome鐵人賽
 看影片追技術